Crear un zFS de más de 4 GB
Qué es un zFS y para qué se usa
Los zFS (z/OS File System) contienen directorios y ficheros que pueden ser accedidos desde la parte UNIX de z/OS (OMVS).
Antes también existía la opción de usar HFS, pero el último z/OS con soporte fue la versión 2.4.
Un zFS es un data set de tipo VSAM lineal. Ese VSAM se monta en un directorio de la parte UNIX (punto de montaje).
Ver los zFS montados
Un sistema tiene varios zFS montados. Para verlos, usaremos el comando:
D OMVS,FILE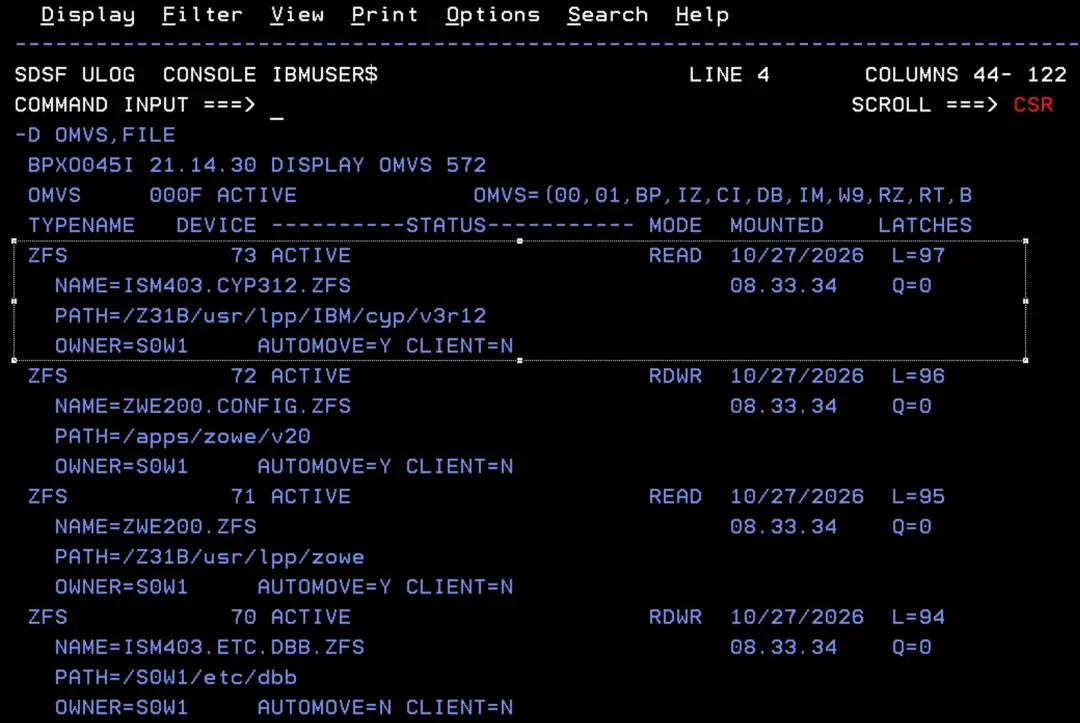
Ver su contenido desde la opción 3.4
Podemos ver el contenido de ese zFS buscando la ruta desde la opción 3.4 de ISPF.
/usr/lpp/IBM/cyp/v3r12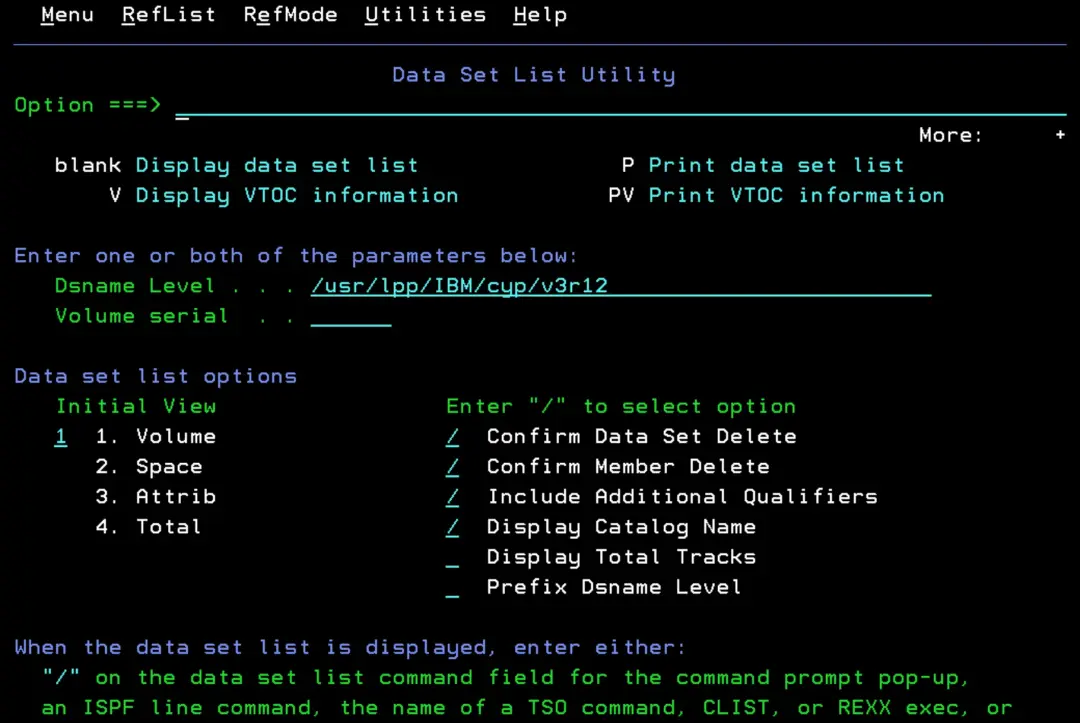
Veremos que tiene 2 directorios.
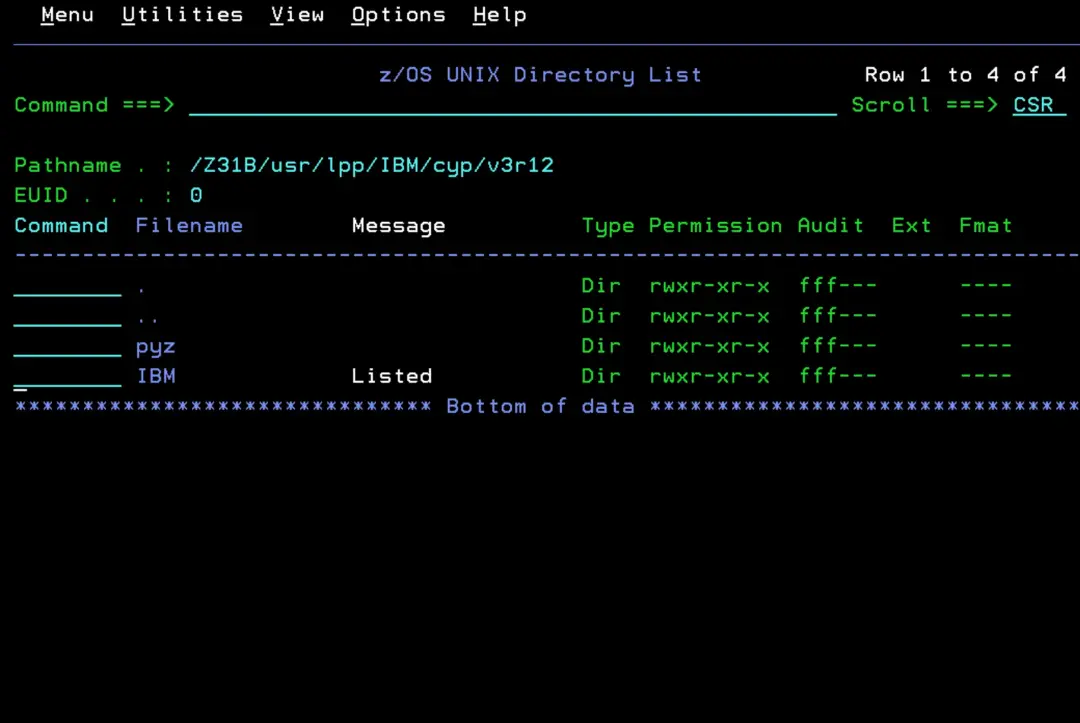
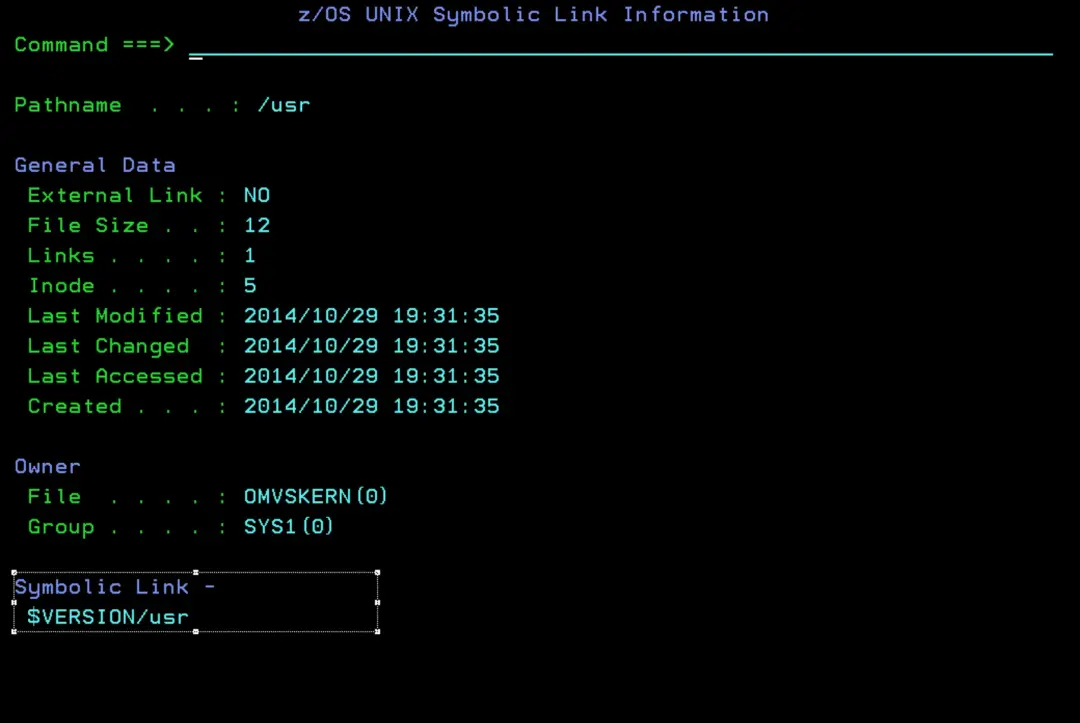
En el display la ruta sale con /Z31B delante porque /usr es un enlace simbólico al root de la versión, así que /usr/lpp/IBM/cyp/v3r12 y /Z31B/usr/lpp/IBM/cyp/v3r12 son el mismo directorio.
Desmontarlo y volverlo a montar
Esto lo hago en mi laboratorio. No desmontes un zFS que esté en uso en un sistema real sin tener claro lo que estás haciendo.
Si desmontamos ese zFS con el siguiente comando de TSO, ya no veremos el contenido y el directorio saldrá vacío:
UNMOUNT FILESYSTEM('ISM403.CYP312.ZFS')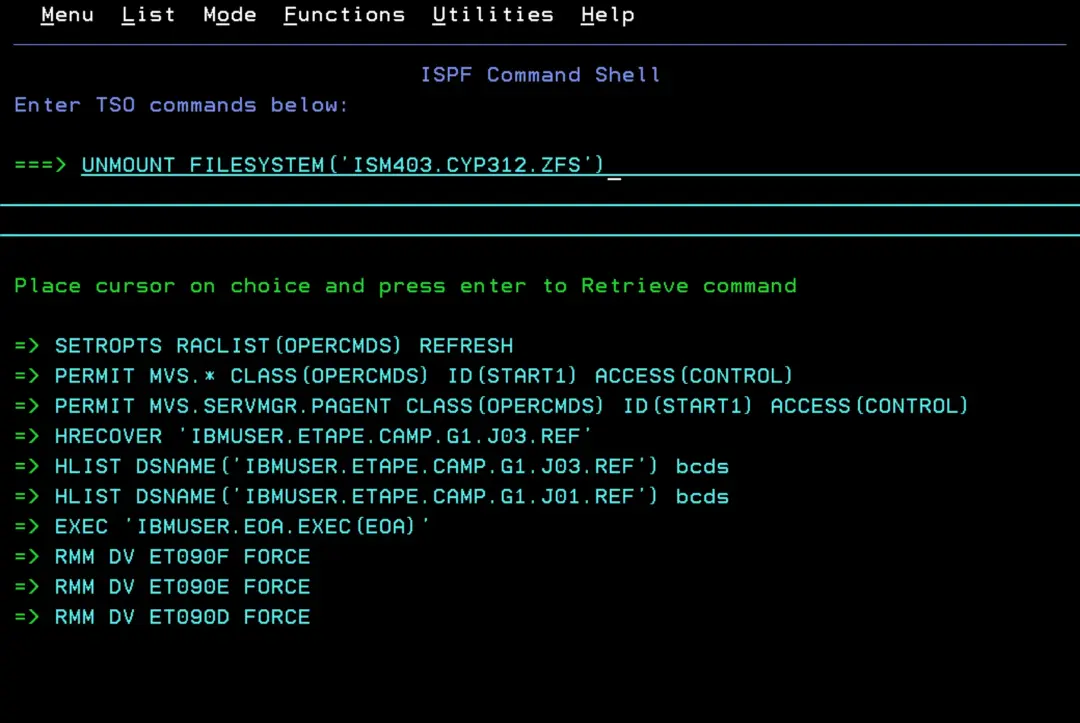
Una vez desmontado, si ahora buscamos la misma ruta, ya no aparecerá el contenido.
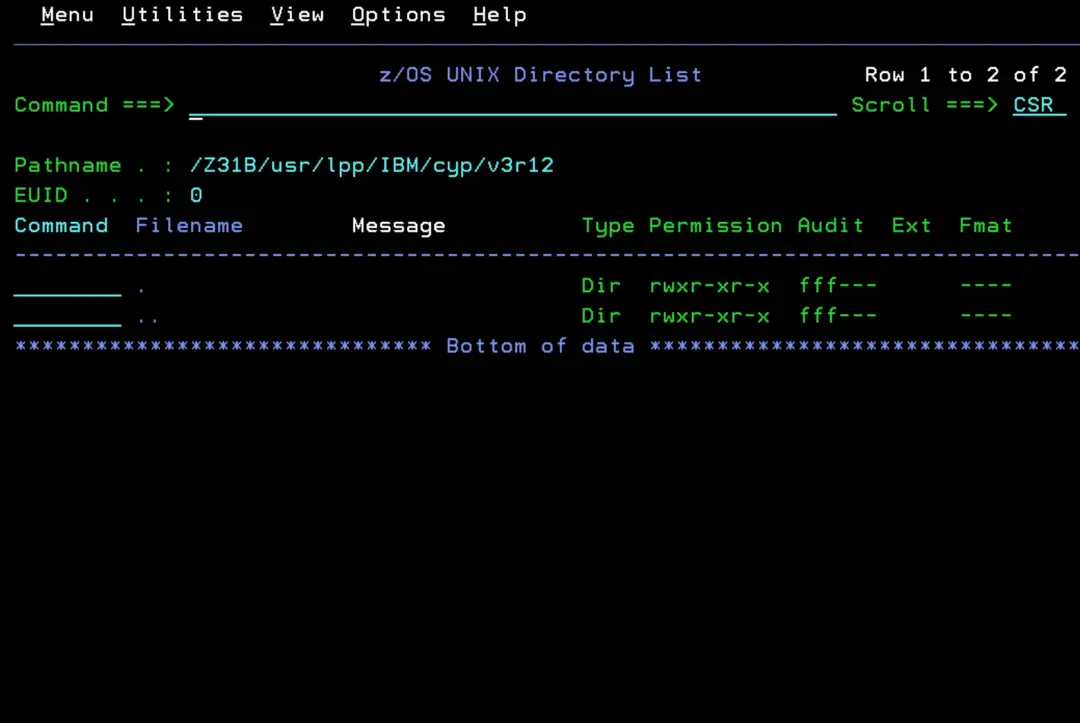
Para volver a montarlo como estaba (en modo lectura):
MOUNT FILESYSTEM('ISM403.CYP312.ZFS') TYPE(ZFS) MODE(READ) MOUNTPOINT('/usr/lpp/IBM/cyp/v3r12')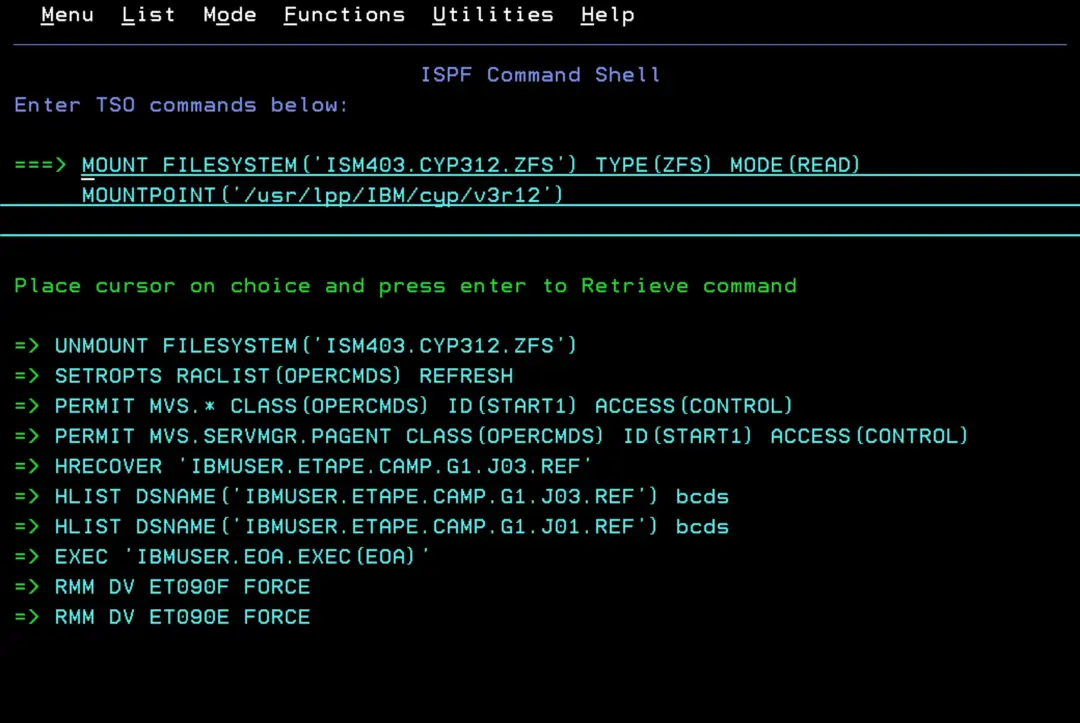
Por qué crear zFS propios
Para evitar llenar zFS importantes del sistema (como el ROOT), normalmente se crean zFS propios para almacenar contenido concreto: los HOME de los usuarios, /etc, /var o productos como Zowe (se ven en el D OMVS,FILE de arriba). Por ejemplo, descargamos una nueva versión de Java y creamos nuestro zFS para guardar ahí el software que hemos descargado y descomprimido.
Los zFS, por defecto, tienen una limitación de 4 GB (debido al VSAM).
Para poder crear zFS más grandes, deberemos hacer uso de alguna dataclass del sistema que tenga configurado el parámetro extended addressability (EA).
Crear un zFS de menos de 4 GB
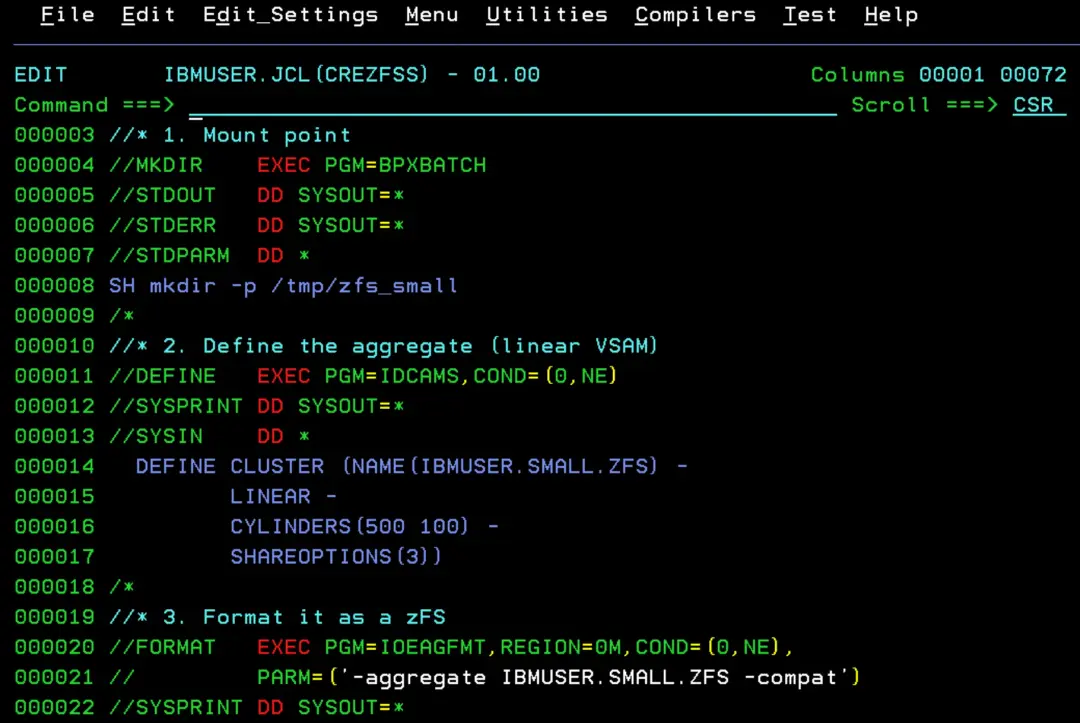
Esto es un JCL de ejemplo para hacer los siguientes pasos:
- BPXBATCH crea el directorio.
- IDCAMS define el VSAM lineal.
- IOEAGFMT lo formatea como zFS.
- MOUNT lo monta.
AGGRGROW: cuando se llena, z/OS lo amplía solo con extensiones secundarias (por eso conviene darle secundario).
Importante desactivar las mayúsculas. CAPS OFF. Si no, la ruta /tmp/zfs_small se guarda en mayúsculas y será otro directorio.
//IBMUSERC JOB (20,FB3),'CREATE ZFS',COND=(0,NE),
//            CLASS=A,MSGCLASS=H,NOTIFY=&SYSUID
//* 1. Mount point
//MKDIR    EXEC PGM=BPXBATCH
//STDOUT   DD SYSOUT=*
//STDERR   DD SYSOUT=*
//STDPARM  DD *
SH mkdir -p /tmp/zfs_small
/*
//* 2. Define the aggregate (linear VSAM)
//DEFINE   EXEC PGM=IDCAMS,COND=(0,NE)
//SYSPRINT DD SYSOUT=*
//SYSIN    DD *
  DEFINE CLUSTER (NAME(IBMUSER.SMALL.ZFS) -
         LINEAR -
         CYLINDERS(500 100) -
         SHAREOPTIONS(3))
/*
//* 3. Format it as a zFS
//FORMAT   EXEC PGM=IOEAGFMT,REGION=0M,COND=(0,NE),
//         PARM=('-aggregate IBMUSER.SMALL.ZFS -compat')
//SYSPRINT DD SYSOUT=*
//STDOUT   DD SYSOUT=*
//STDERR   DD SYSOUT=*
//* 4. Mount it
//MOUNT    EXEC PGM=IKJEFT01,COND=(0,NE)
//SYSTSPRT DD SYSOUT=*
//SYSTSIN  DD *
  MOUNT FILESYSTEM('IBMUSER.SMALL.ZFS') +
        MOUNTPOINT('/tmp/zfs_small') +
        TYPE(ZFS) MODE(RDWR) +
        PARM('AGGRGROW')
/*
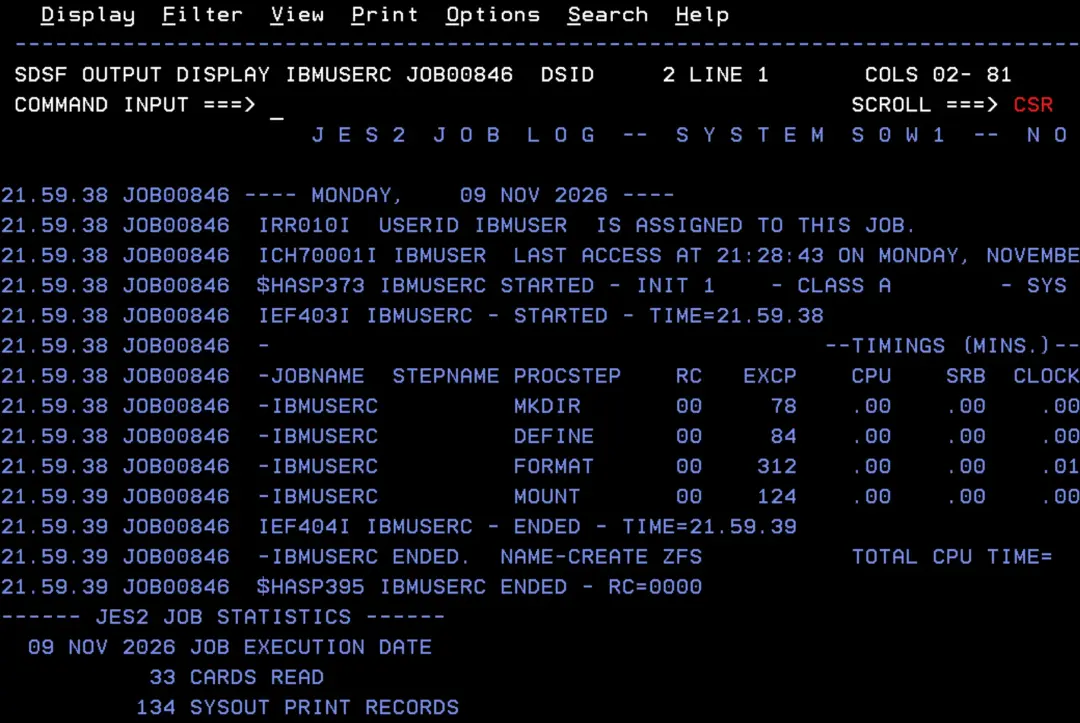
Terminará correctamente.
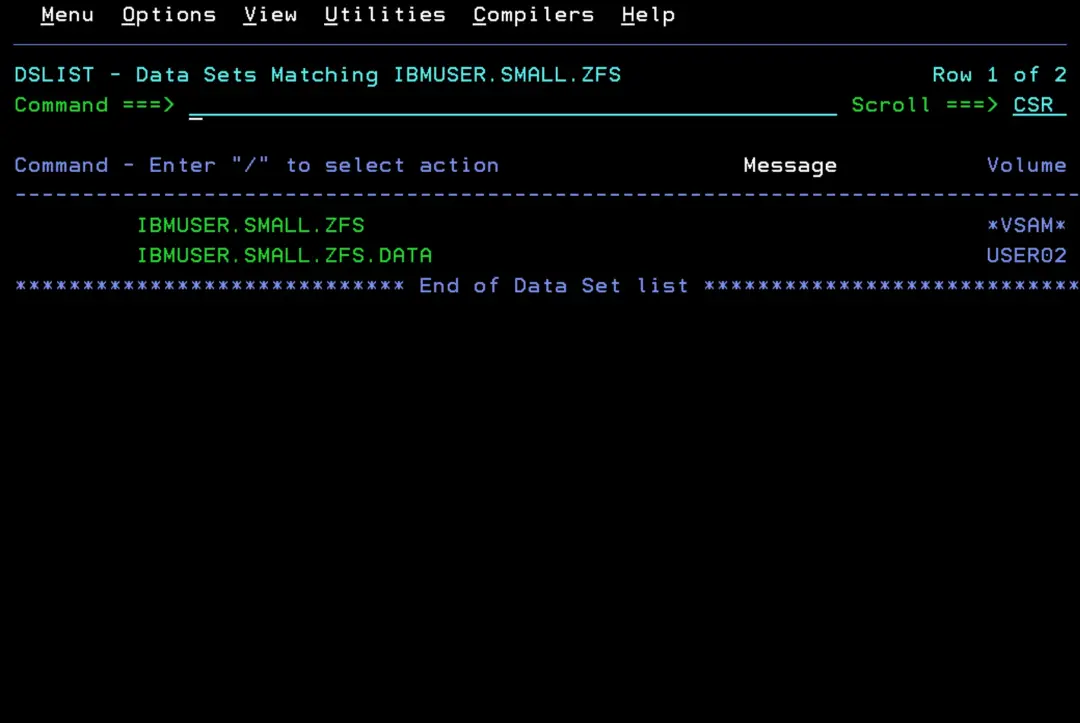
En 3.4 vemos el zFS creado.
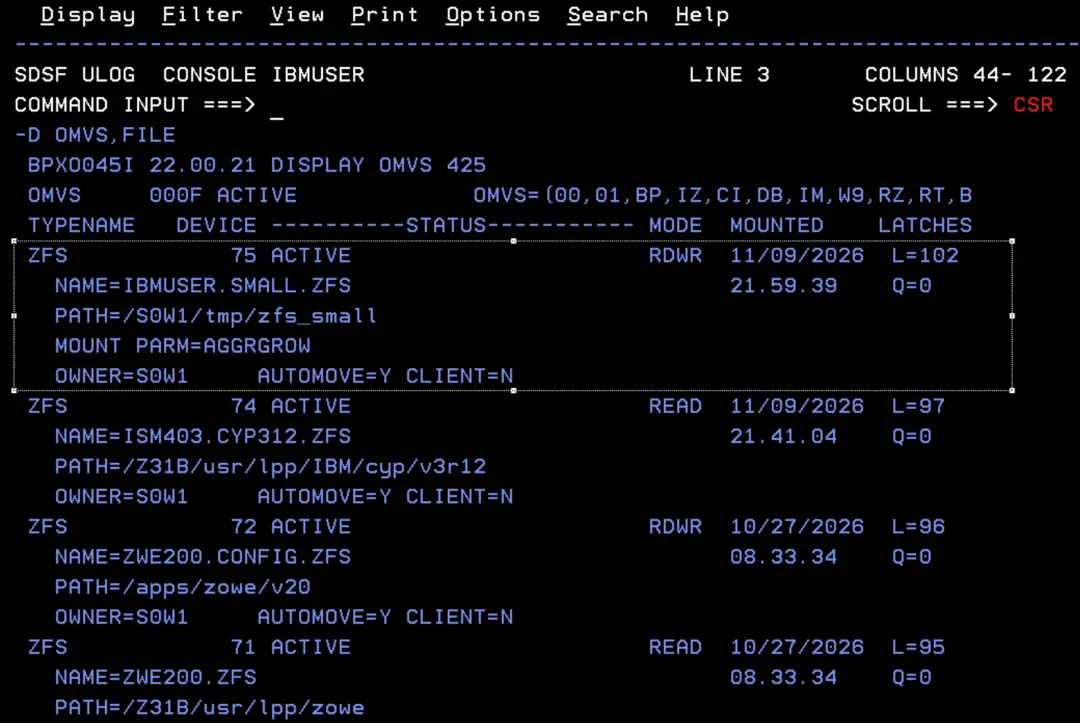
En el recuadro vemos que el zFS ya está montado.
El límite de 4 GB
Un VSAM normal no puede pasar de 4 GB. Por eso un zFS creado como el de arriba tampoco: aunque tenga AGGRGROW, llegará a 4 GB y no crecerá más.
- 4 GB son unos 5.825 cilindros (un cilindro de VSAM lineal son 737.280 bytes: 12 bloques de 4 KB por pista × 15 pistas).
Para crear uno más grande, el VSAM necesita extended addressability (EA), y eso no se pide en el DEFINE: lo da la data class de SMS.
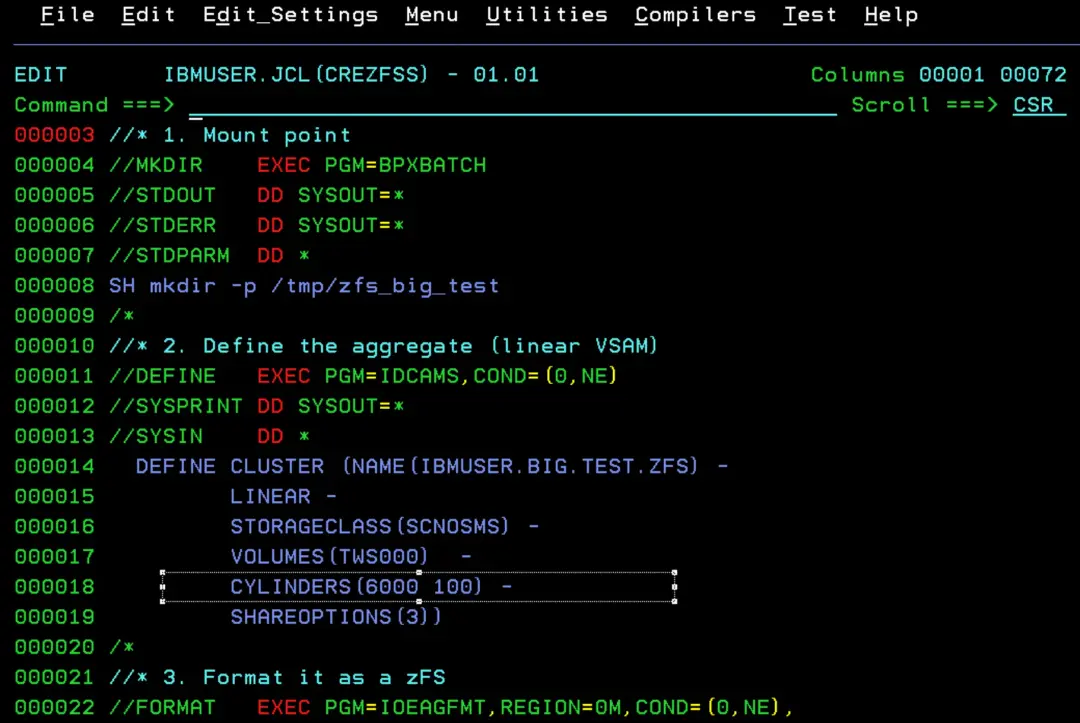
Voy a lanzar un job de 6000 cilindros como el de la imagen para ver el error que obtendremos al no poder crear este fichero.
STORAGECLASS(SCNOSMS) y VOLUMES los uso para usar un disco NOSMS para evitar mis rutinas SMS para esta prueba.
El paso DEFINE terminará con RC=12. Además, veremos el siguiente error:
IDC3014I CATALOG ERROR
IDC3009I ** VSAM CATALOG RETURN CODE IS 140 - REASON CODE IS
IDC3009I IGG0CLEV-110
IDC3003I FUNCTION TERMINATED. CONDITION CODE IS 12

IDC0002I IDCAMS PROCESSING COMPLETE. MAXIMUM CONDITION CODE WAS 12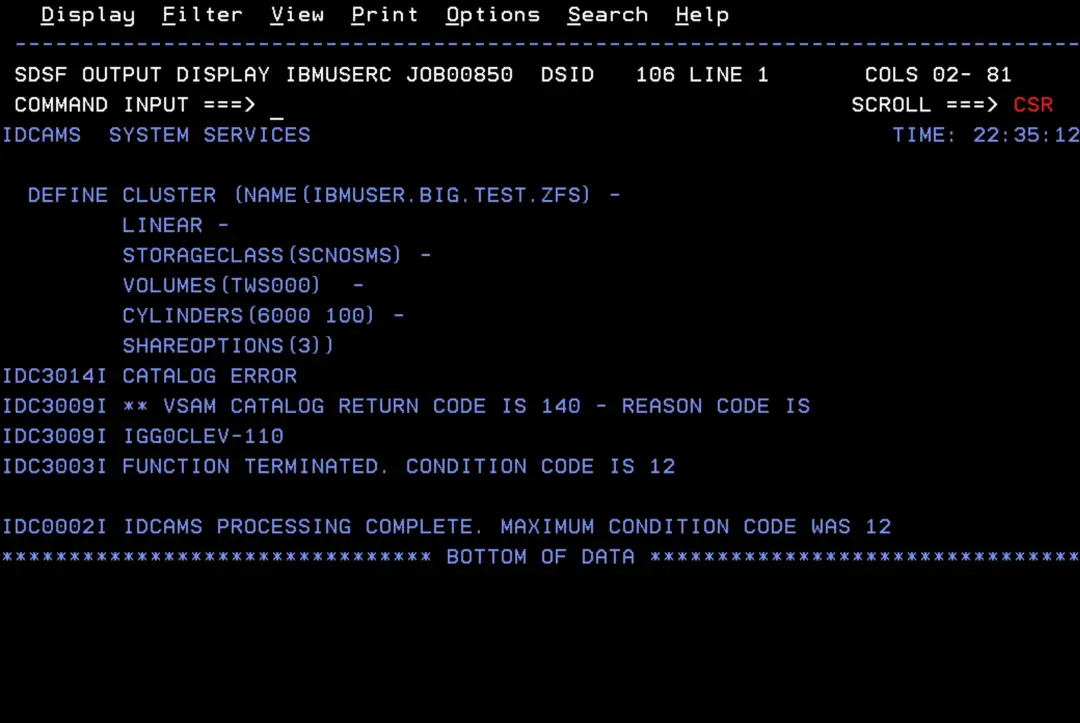
Por este motivo, los zFS de más de 4 GB deberán estar gestionados por SMS, con una data class que tenga extended addressability.
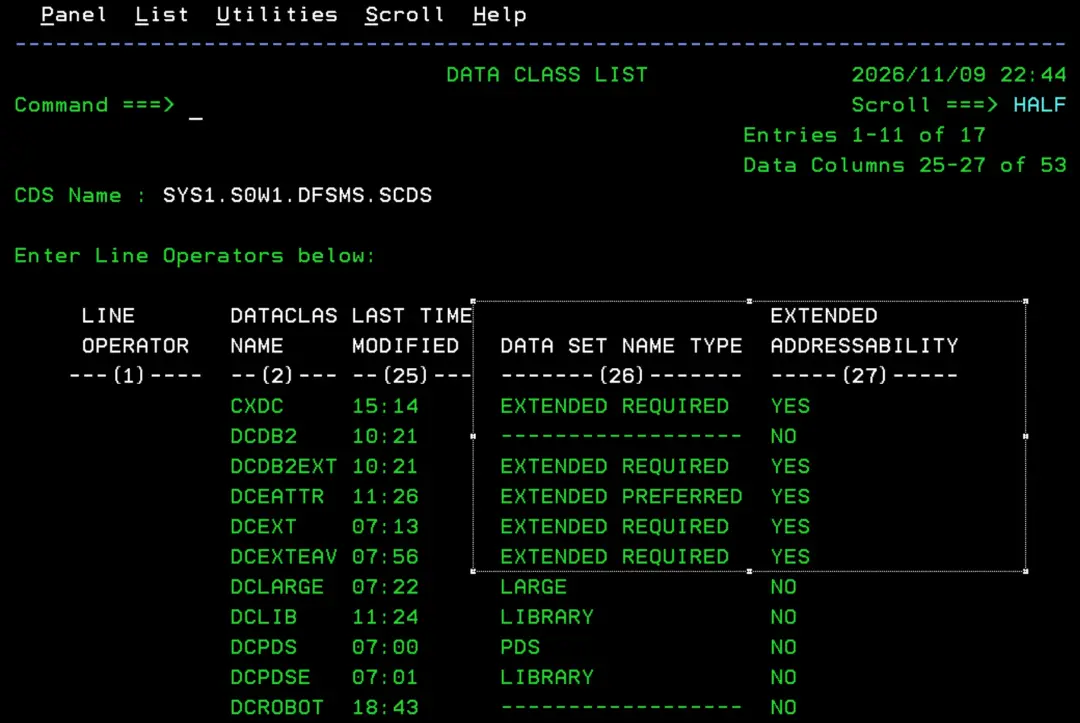
Ver las clases de datos en ISMF
Entramos en ISMF → opción 4 Data Class.
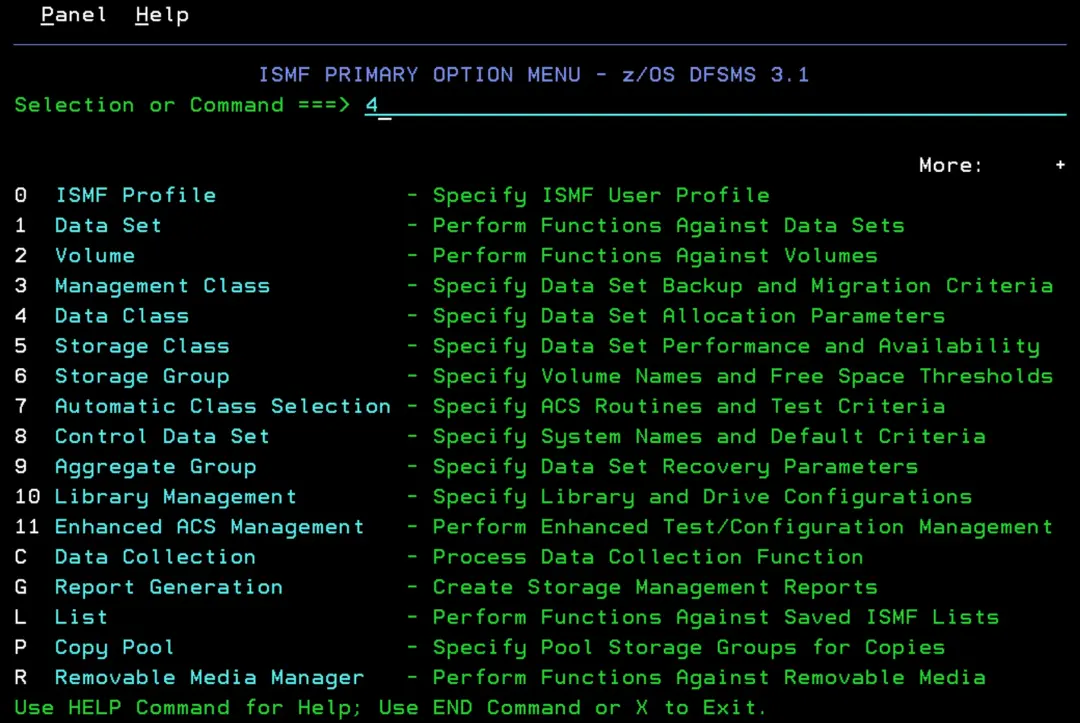
Opción 1 List
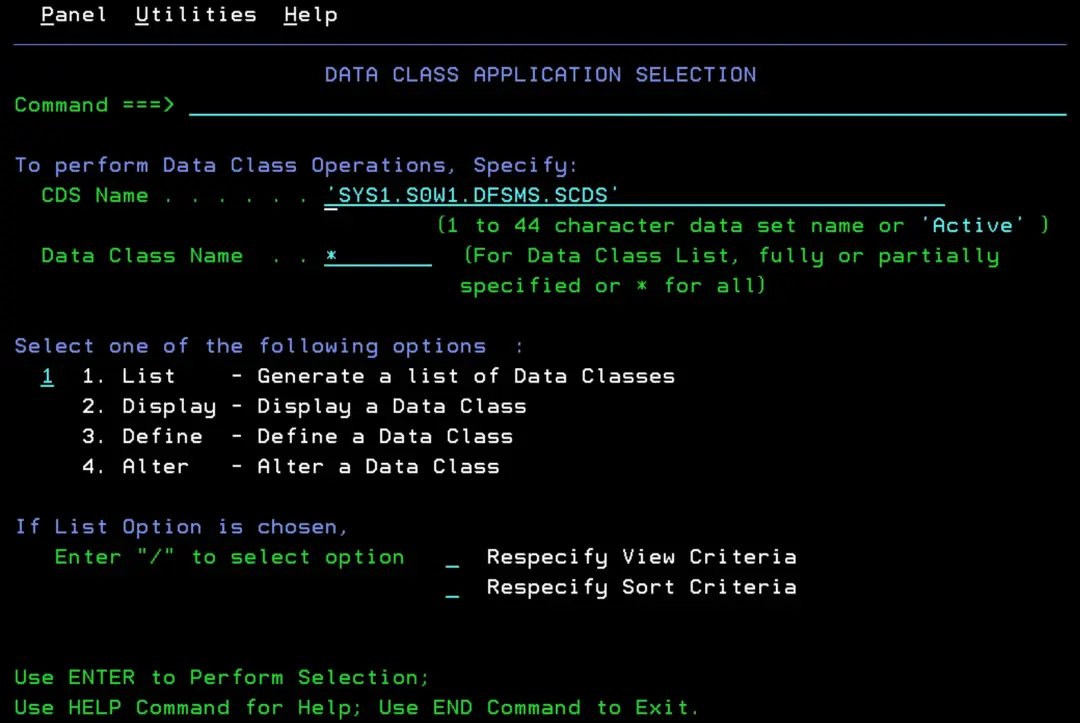
Buscaremos una que cumpla:
- Data Set Name Type = EXTENDED
- Extended Addressability = YES
Crear un zFS de más de 4 GB
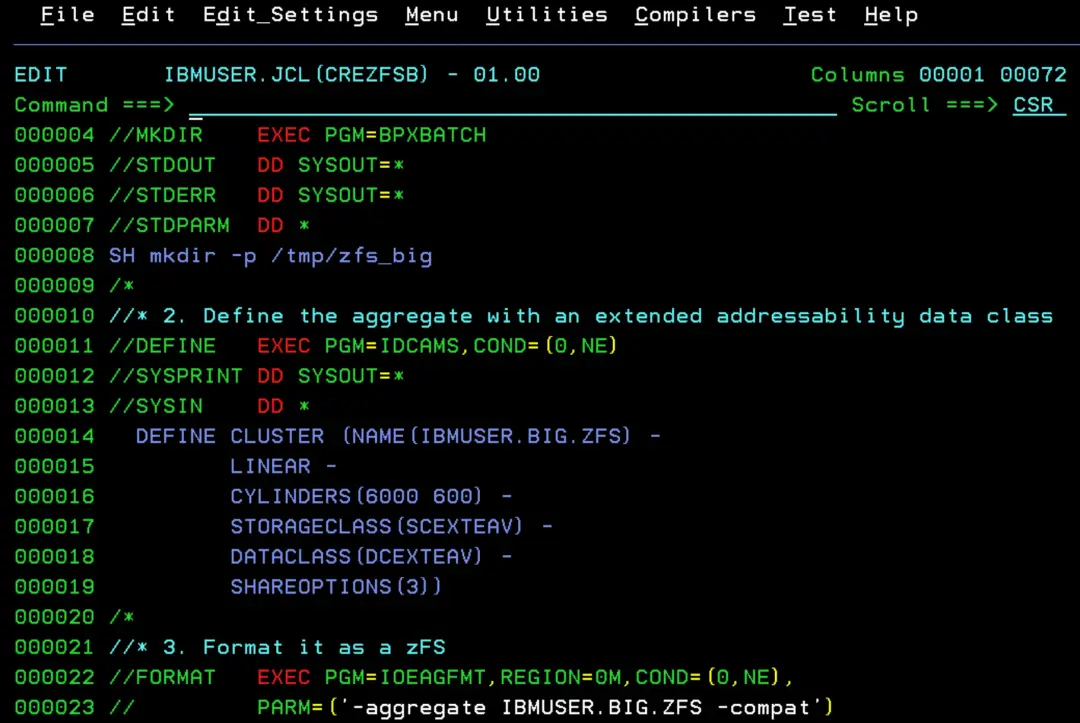
Con este JCL de ejemplo podemos crear el zFS de más de 4 GB incluyendo la DATACLASS (en mi caso, DCEXTEAV). También le añadiré la STORAGECLASS SCEXTEAV que está definida en este sistema.
//IBMUSERC JOB (20,FB3),'CREATE ZFS',COND=(0,NE),
//            CLASS=A,MSGCLASS=H,NOTIFY=&SYSUID
//* 1. Mount point
//MKDIR    EXEC PGM=BPXBATCH
//STDOUT   DD SYSOUT=*
//STDERR   DD SYSOUT=*
//STDPARM  DD *
SH mkdir -p /tmp/zfs_big
/*
//* 2. Define the aggregate with an extended addressability data class
//DEFINE   EXEC PGM=IDCAMS,COND=(0,NE)
//SYSPRINT DD SYSOUT=*
//SYSIN    DD *
  DEFINE CLUSTER (NAME(IBMUSER.BIG.ZFS) -
         LINEAR -
         CYLINDERS(6000 600) -
         STORAGECLASS(SCEXTEAV) -
         DATACLASS(DCEXTEAV) -
         SHAREOPTIONS(3))
/*
//* 3. Format it as a zFS
//FORMAT   EXEC PGM=IOEAGFMT,REGION=0M,COND=(0,NE),
//         PARM=('-aggregate IBMUSER.BIG.ZFS -compat')
//SYSPRINT DD SYSOUT=*
//STDOUT   DD SYSOUT=*
//STDERR   DD SYSOUT=*
//* 4. Mount it
//MOUNT    EXEC PGM=IKJEFT01,COND=(0,NE)
//SYSTSPRT DD SYSOUT=*
//SYSTSIN  DD *
  MOUNT FILESYSTEM('IBMUSER.BIG.ZFS') +
        MOUNTPOINT('/tmp/zfs_big') +
        TYPE(ZFS) MODE(RDWR) +
        PARM('AGGRGROW')
/*
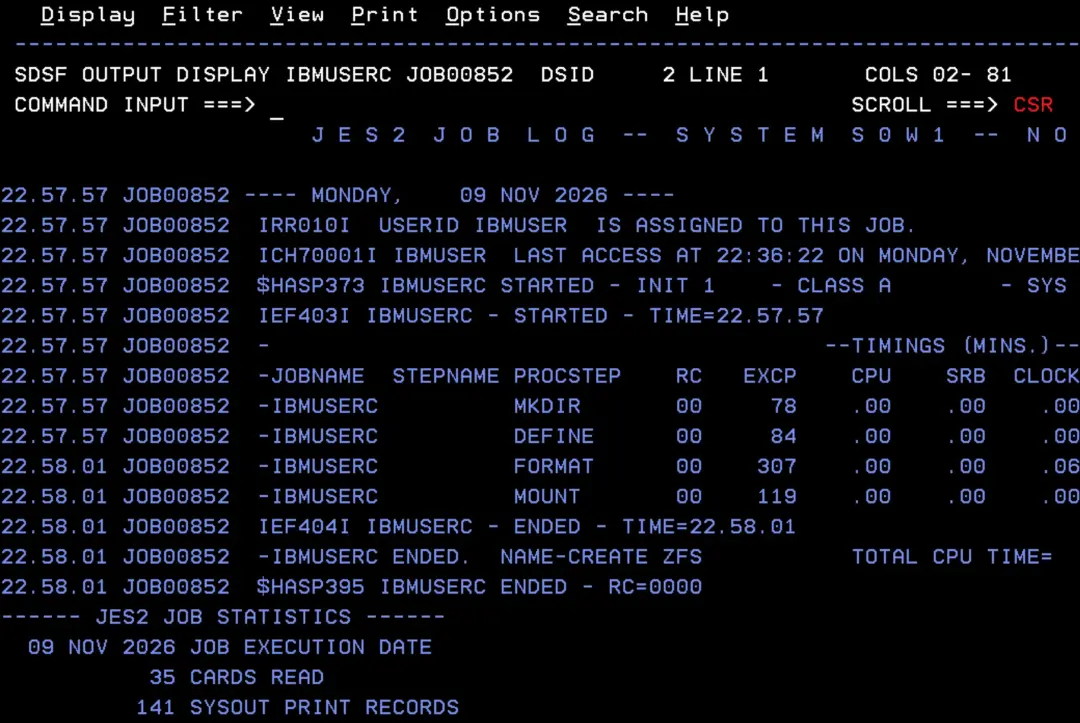
El job terminará bien.
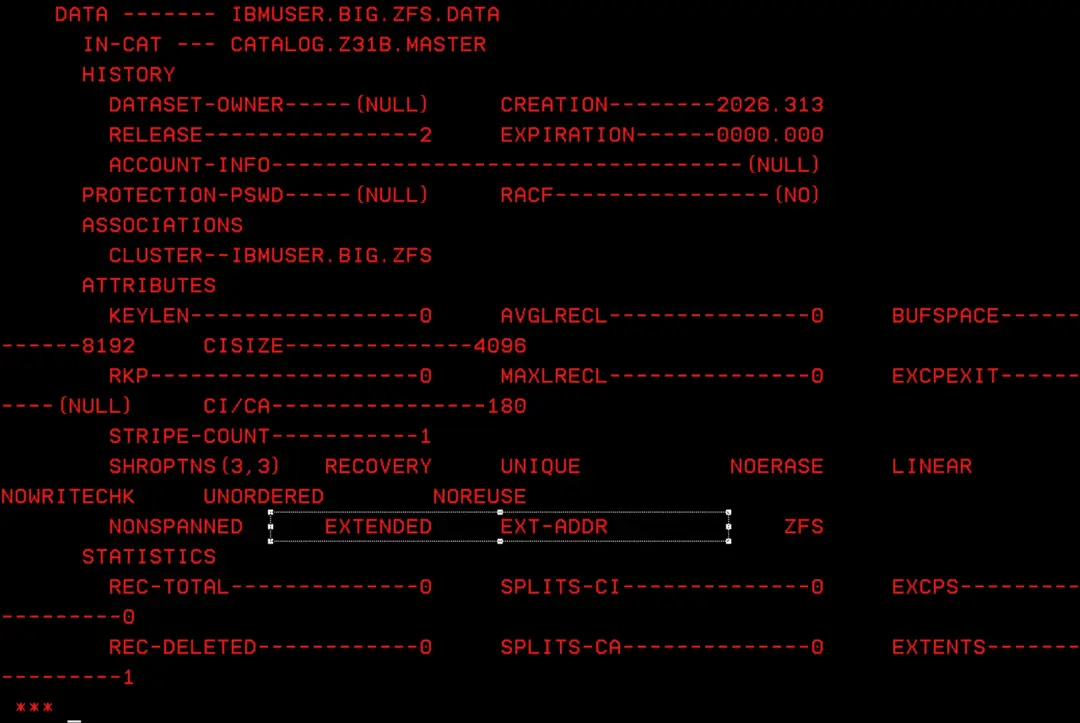
Si hacemos un LISTCAT del VSAM, veremos que tiene el atributo EXT-ADDR. El comando se escribe en la 3.4 al lado del data set: el sistema sustituye la / por su nombre.
listc ent(/) all 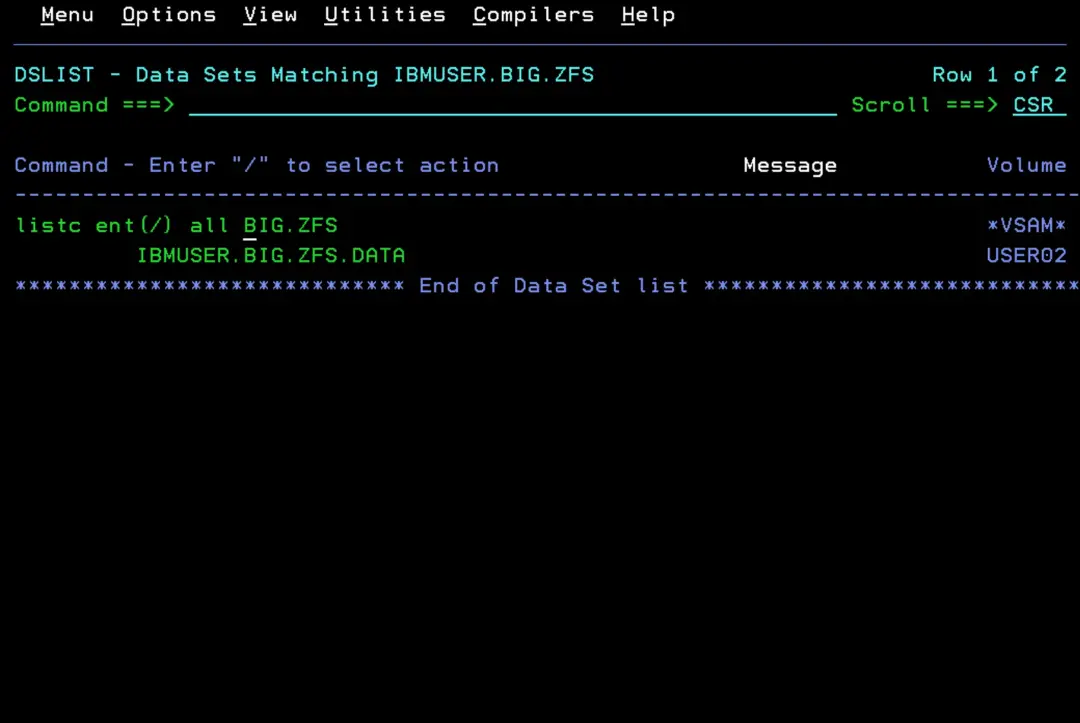
Ahora comprobaremos que está bien montado. Desde la consola (o SDSF con /):
D OMVS,FILE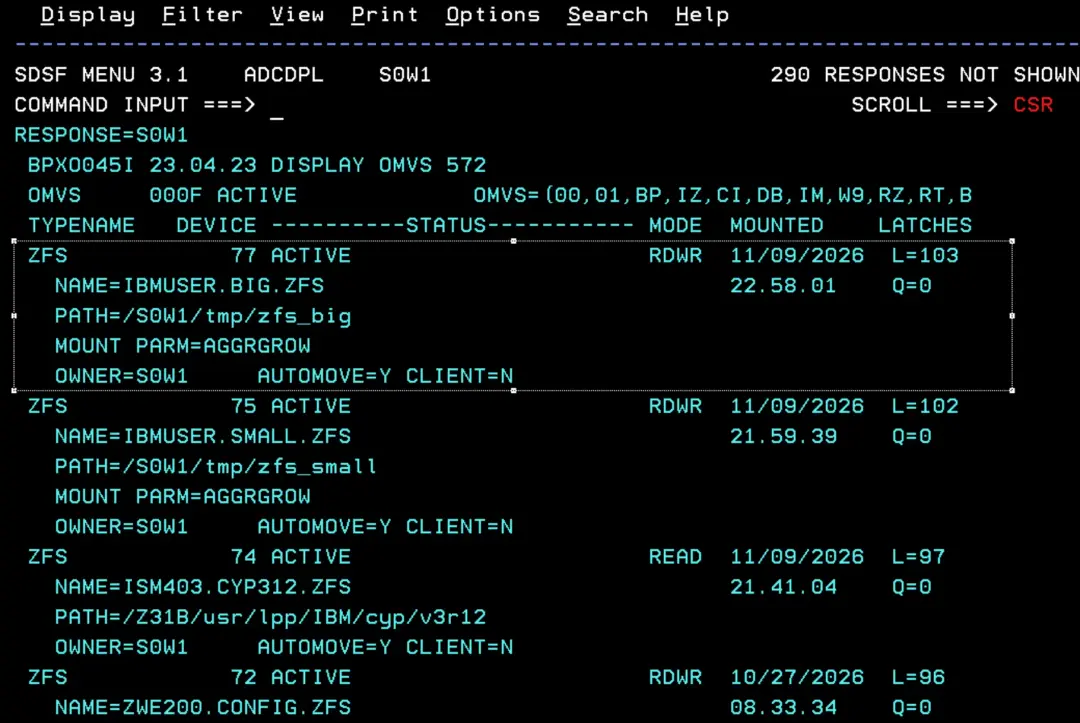
Desde OMVS, podemos usar el siguiente comando para ver la capacidad de ambos y el espacio utilizado:
df -kP /tmp/zfs_small /tmp/zfs_big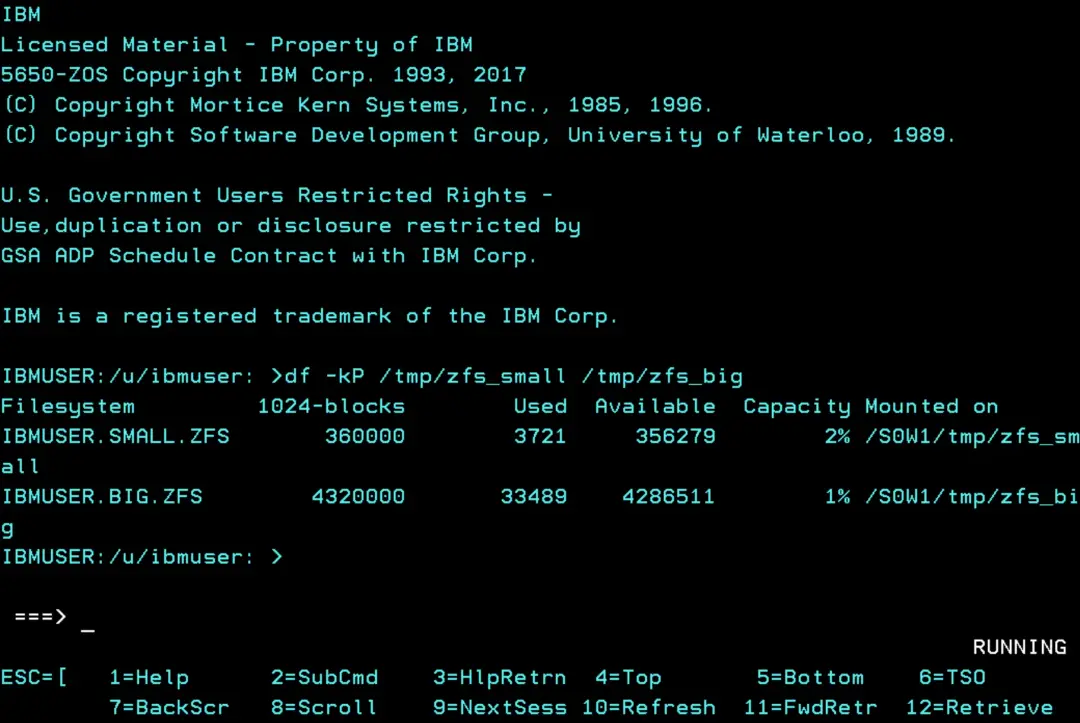
Con los jobs de ejemplo, estos zFS quedan montados hasta el siguiente IPL. Para que queden montados después de un IPL deberemos añadirlos al miembro de PARMLIB BPXPRMxx (en otra entrada lo explicaré con detalle).
Generar el job con la herramienta
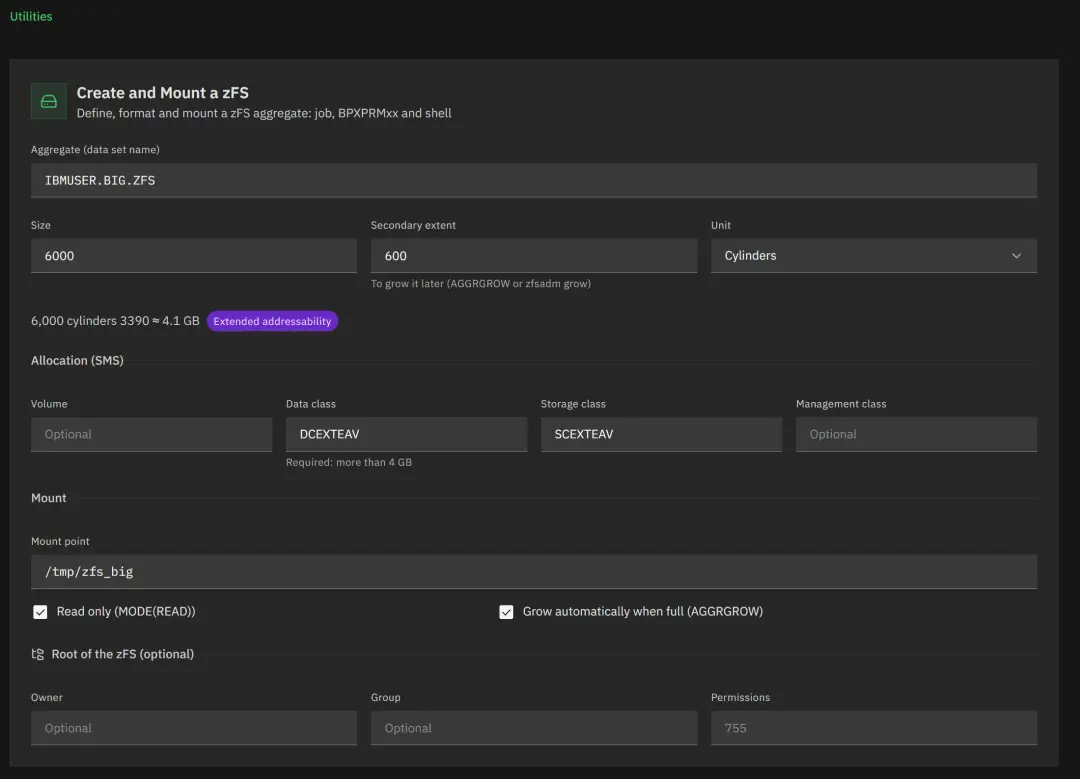
En la web tengo una herramienta que genera todo lo que hemos visto en esta entrada: Crear y montar un zFS.
Solo hay que rellenar estos datos:
- Agregado: el nombre del data set, por ejemplo IBMUSER.BIG.ZFS.
- Tamaño y extensión secundaria: en cilindros, MB o GB. La herramienta lo convierte a cilindros 3390 y muestra cuánto ocupa.
- Asignación (SMS): volumen, data class, storage class y management class. Aquí es donde pondríamos DCEXTEAV y SCEXTEAV.
- Montaje: el punto de montaje, si lo queremos en solo lectura (MODE(READ), como el zFS de cyp que desmontamos al principio) y si queremos AGGRGROW.
- Raíz del zFS (opcional): propietario, grupo y permisos del directorio. Añade un paso más al job con chown y chmod.
Con eso genera cuatro cosas, cada una en su pestaña:
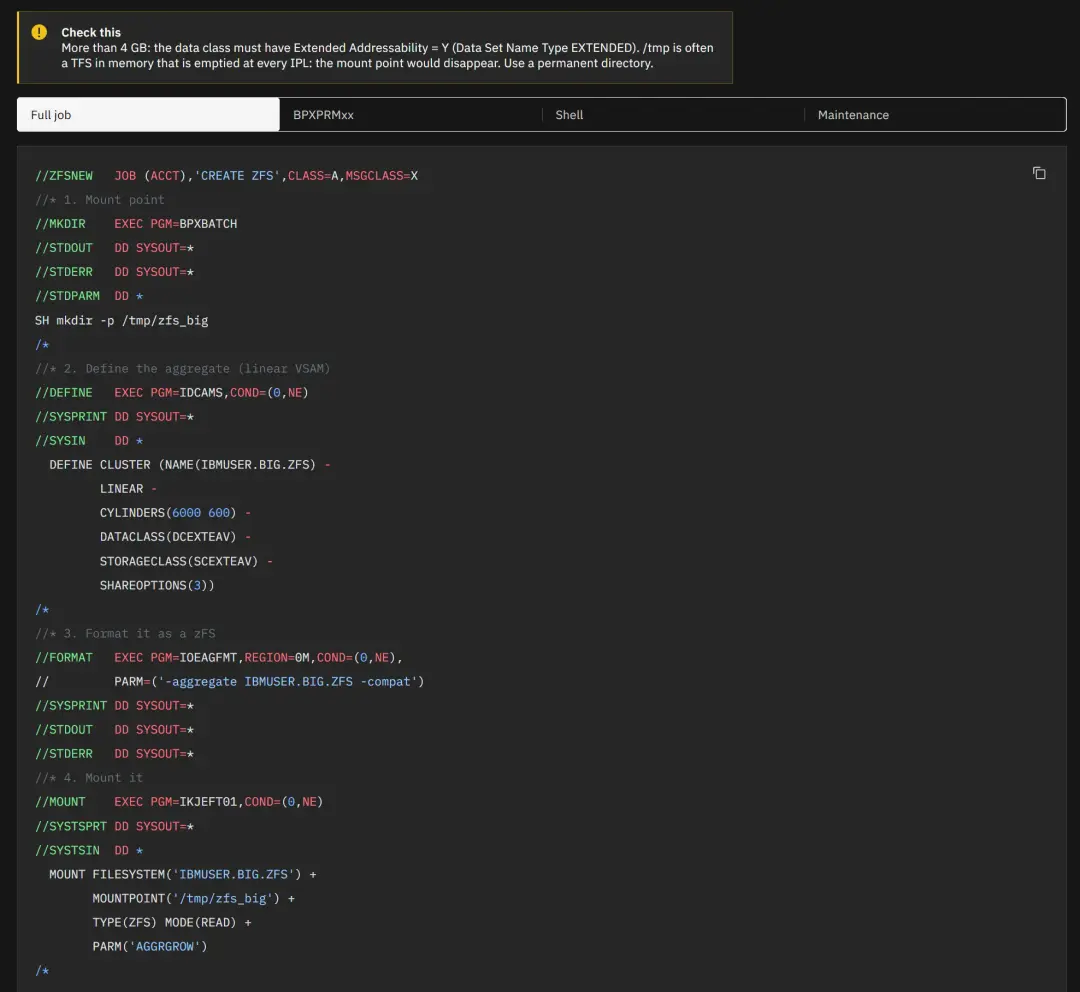
- Job completo: el mismo job que hemos usado en la entrada (mkdir, DEFINE, IOEAGFMT y MOUNT).
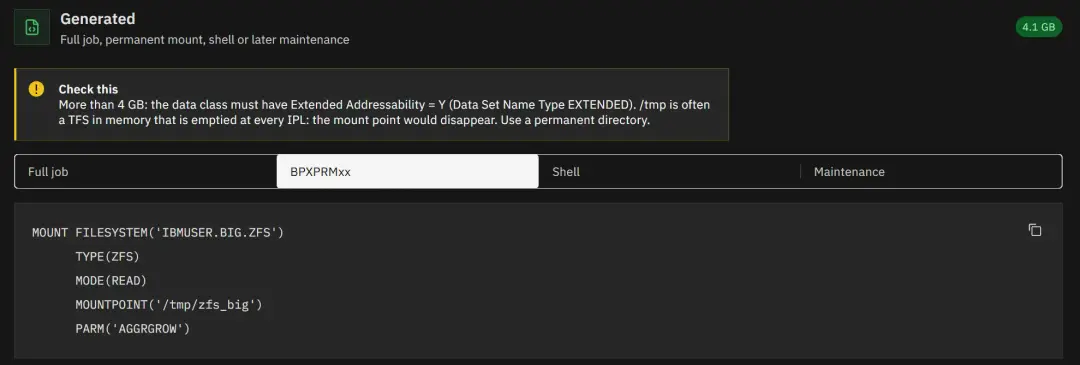
- BPXPRMxx: la sentencia MOUNT para que el zFS se monte en cada IPL.
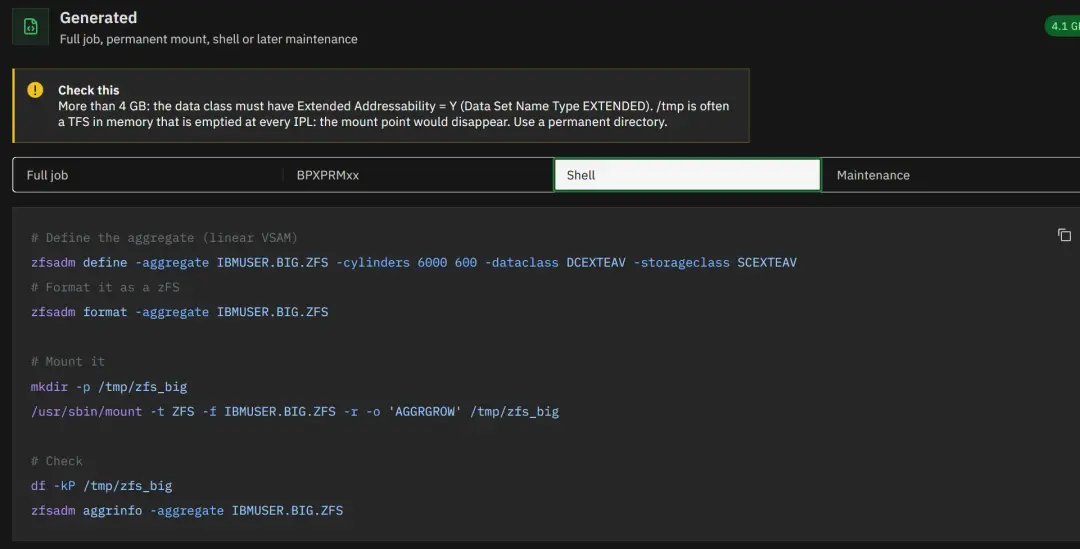
- Shell: lo mismo desde OMVS con zfsadm, y los comandos df -kP y zfsadm aggrinfo para comprobarlo.
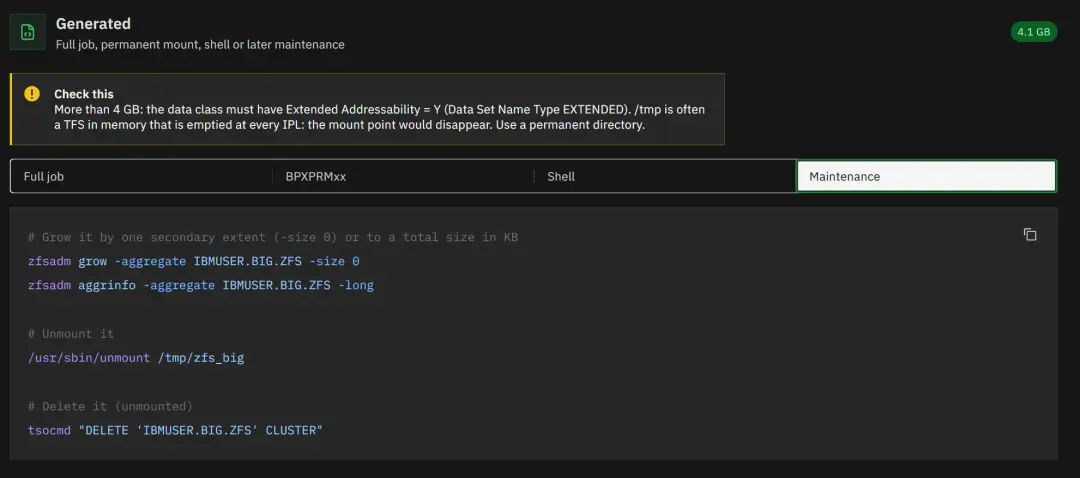
- Mantenimiento: los comandos para ampliarlo (zfsadm grow), desmontarlo y borrarlo.
Además, antes de lanzar el job revisa lo que hemos visto en esta entrada:
- Si el tamaño pasa de 5.825 cilindros (4 GB), lo marca como extended addressability y la data class pasa a ser obligatoria. Así no nos encontramos con el RC=12 del DEFINE.
- Si el punto de montaje está dentro de /tmp, avisa de que se puede vaciar en cada IPL. Para estas pruebas me vale, pero para un zFS que vaya a durar es mejor un directorio permanente.
- Si pasa de 65.520 cilindros, avisa de que no cabe en un 3390 normal y necesita un volumen EAV o varios volúmenes.
- Si marcamos AGGRGROW sin extensión secundaria, avisa de que no podrá crecer.
La herramienta nos indicará que la data class es necesaria cuando supera los 4 GB.
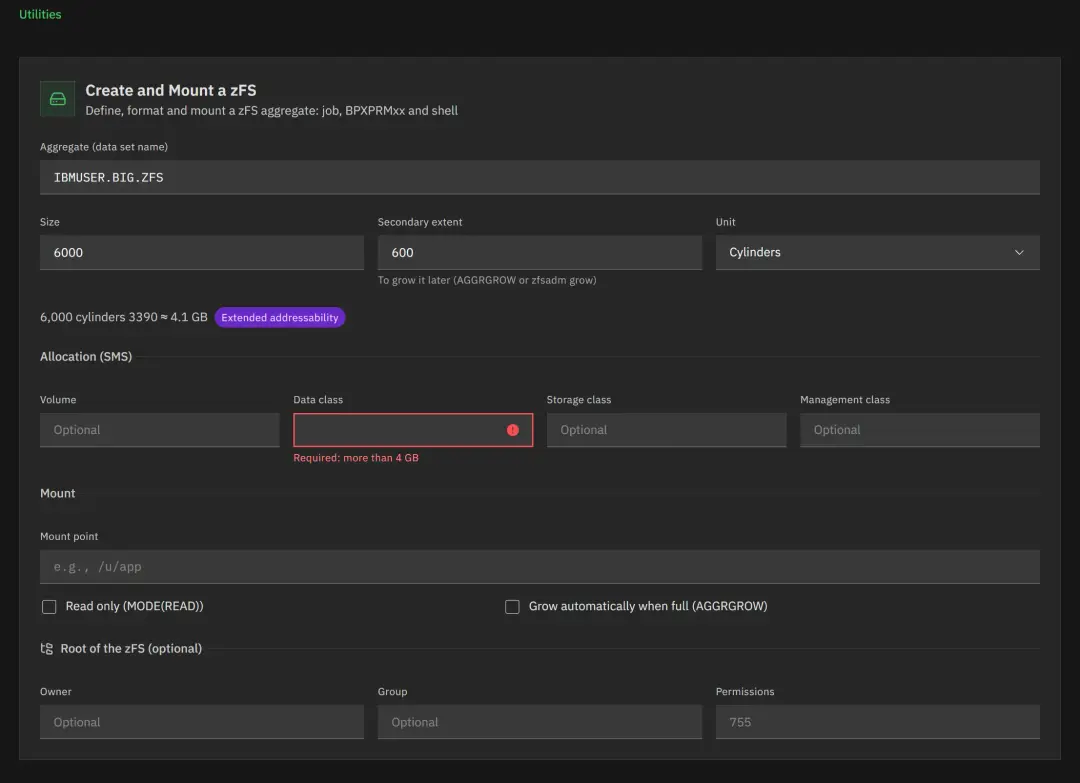
Los datos quedarían así.
En la herramienta, más abajo, veremos el job completo.
También veremos el parámetro para BPXPRMxx.
También veremos la opción de crearlo a través de comandos Shell.
Y en la última opción vemos algunos comandos de mantenimiento.